
DeepSeek khung suy luận mã nguồn mở, đo lường lợi nhuận suy luận trên mạng xã hội có thể vượt quá 95%
DeepSeek là một khung suy diễn mã nguồn mở, đã chuyển hướng cuộc thảo luận trong ngành mô hình lớn từ khả năng của mô hình sang chi phí suy diễn.
Vào ngày 20 tháng 10, DeepSeek đã công bố mã nguồn mở khung suy diễn nội bộ DeepInfer, cũng như deepseek-recipe được sử dụng cho mã hóa và giải mã Token. DeepSeek cho biết, DeepInfer phục vụ cho suy diễn quy mô lớn của DeepSeek V4.1-Flash, với mục tiêu giảm độ trễ trong khi tăng thông lượng. Khung này hỗ trợ GPU của NVIDIA và NPU Ascend của Huawei, sử dụng giấy phép mã nguồn mở Apache-2.0.
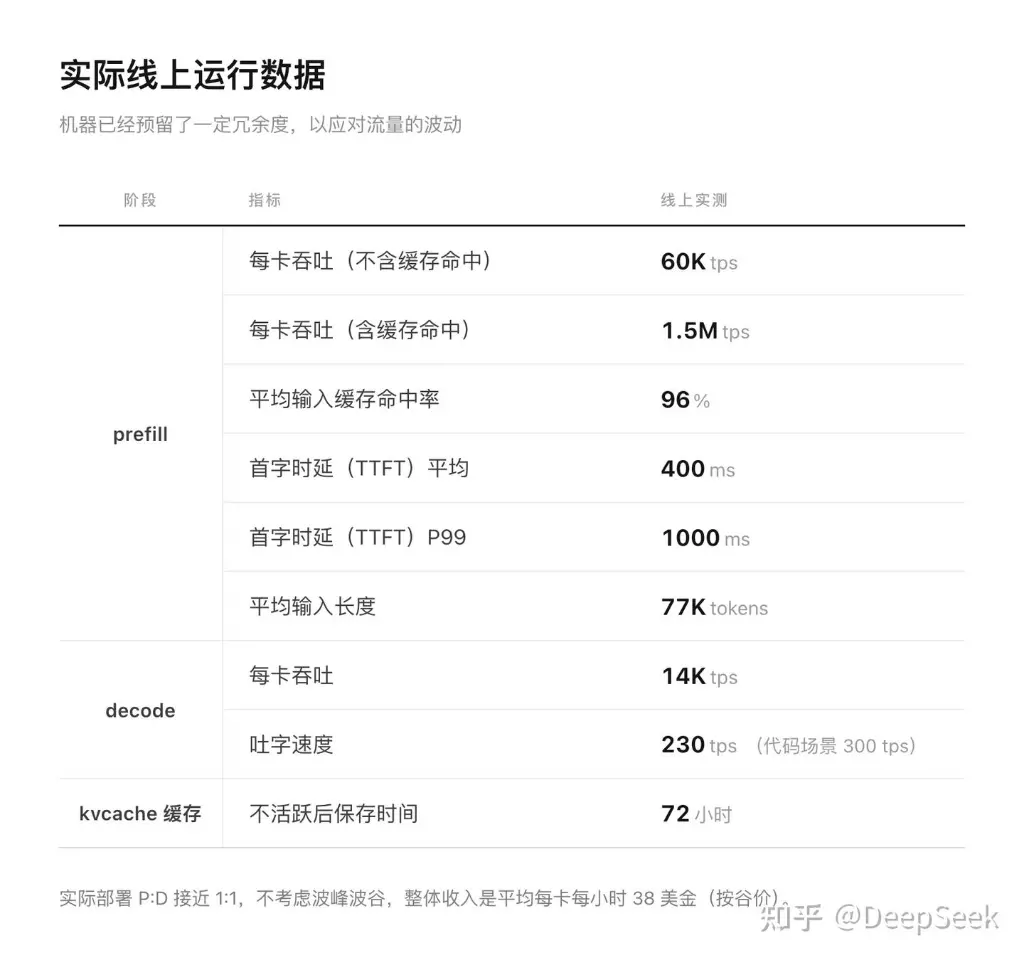
Một bối cảnh thu hút sự chú ý trong lần mã nguồn mở này là doanh thu từ dịch vụ suy diễn mà DeepSeek đã công bố. Theo câu hỏi và câu trả lời về triển khai mà DeepSeek công bố trên GitHub, V4.1-Flash có thể xử lý 1.55 triệu tỷ Token mỗi ngày trên một cụm, với doanh thu tổng thể đạt 38 đô la mỗi giờ mỗi GPU theo giá điện trong giờ cao điểm.
Dựa trên giả định về tỷ lệ lưu trữ, thông lượng và định giá, các phương tiện truyền thông xã hội ước tính tỷ lệ lợi nhuận gộp từ suy diễn có thể cao nhất lên tới 84.2%---96.1%. Các nhà phân tích chỉ ra rằng tỷ lệ lợi nhuận gộp API của các mô hình chính thống của OpenAI và Anthropic cũng tương tự hoặc đạt 95%.
Sự công bố này đã cung cấp cho bên ngoài một cái nhìn về kinh tế suy diễn. Tuy nhiên, con số doanh thu tự nó không thể cho thấy mức lợi nhuận. Để xác định doanh thu 38 đô la mỗi giờ tương ứng với bao nhiêu lợi nhuận gộp, cần biết thêm về chi phí khấu hao phần cứng, năng lượng, mạng, lưu trữ bộ nhớ đệm và vận hành.
Tính toán tỷ lệ lợi nhuận gộp trên mạng xã hội cao hơn 96%
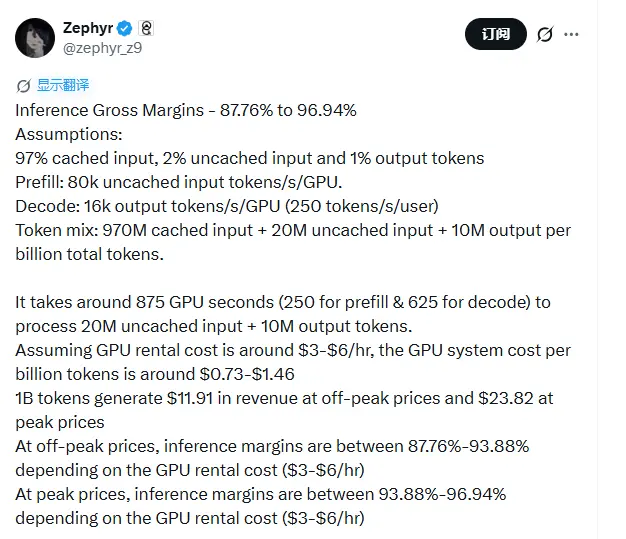
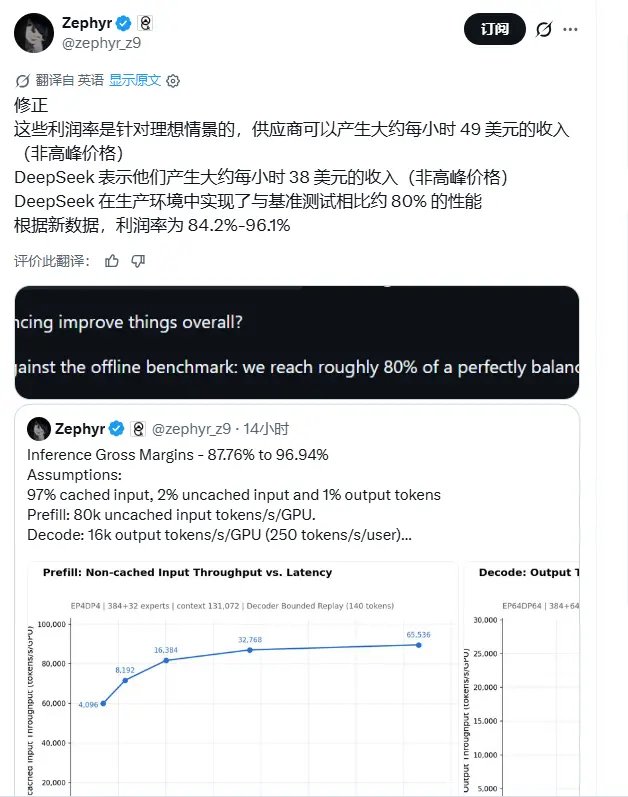
Nhà nghiên cứu đầu tư công nghệ nước ngoài Zephyr đã công bố một tính toán trên nền tảng xã hội X, chỉ ra rằng DeepSeek thực sự "đã công khai công thức bí mật cốt lõi phía sau mô hình kinh doanh của mình". Ông ước tính, tỷ lệ lợi nhuận gộp từ suy diễn của DeepSeek có thể đạt 84.2%---96.1%, đã điều chỉnh khoảng 87.76%---96.94% mà ông đã đưa ra trước đó.
Ông đã thiết lập một mô hình cơ bản điển hình: giả định trong sản xuất thực tế, 97% đầu vào trúng bộ nhớ đệm khóa giá trị, trong khi đầu vào không trúng bộ nhớ đệm chiếm 2%, đầu ra chiếm 1%.
Đầu vào bộ nhớ đệm (Cached Input): chiếm 97% tổng số Token (giá rất thấp, tải tính toán rất nhẹ);
Đầu vào không bộ nhớ đệm (Uncached Input/Prefill): chiếm 2% tổng số Token;
Đầu ra (Output/Decode): chiếm 1% tổng số Token.
Dưới cấu trúc lưu lượng này, Zephyr kết hợp với thông lượng tối đa của thẻ đơn mà chính thức công bố (tiền lấp đầy 80.000 Token mỗi giây, giải mã 16.000 Token mỗi giây) để tính toán giá trị sản xuất. Theo mô hình của ông, một GPU chạy đầy tải lý thuyết có thể xử lý các tổ hợp Token tương ứng và tạo ra doanh thu tối đa khoảng 49 đô la mỗi giờ.
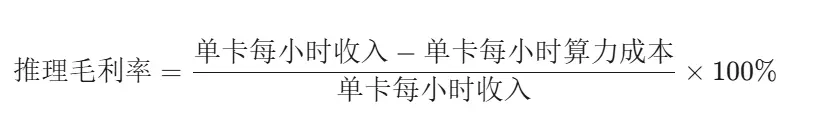
Nếu theo chi phí thuê tổng hợp cho một GPU hàng đầu (như NVIDIA H100 hoặc phần cứng thế hệ tiếp theo tương tự) trên thị trường đám mây công cộng nước ngoài hiện tại, thường dao động từ 1.5 đến 4 đô la mỗi giờ, thì công thức tỷ lệ lợi nhuận gộp từ suy diễn ở cấp độ phần cứng là:
Trong điều kiện thử nghiệm cực hạn (doanh thu 49 đô la mỗi giờ, chi phí tính toán từ 1.5 đến 6 đô la):
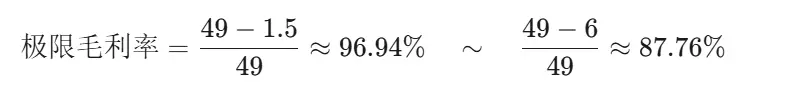
Zephyr cho biết, dưới tải lý tưởng cụ thể, tỷ lệ lợi nhuận gộp từ dịch vụ suy diễn (Inference Gross Margin) của khung này nằm trong khoảng từ 87.76% đến 96.94%. Ông thẳng thắn trong tweet của mình: "Công khai hiệu suất của NVIDIA, SGLang và vLLM đã bị nghiền nát."
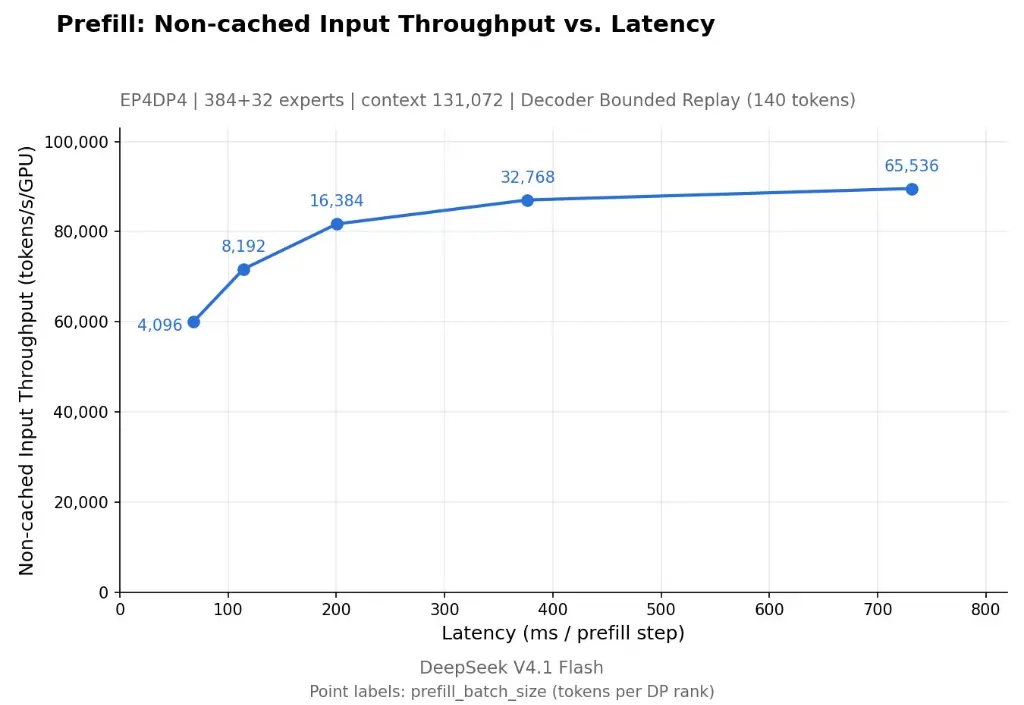
Sau đó, Zephyr đã điều chỉnh các tham số tính toán dựa trên chi tiết hoạt động thực tế mà DeepSeek công bố. Ông bổ sung: "Những lợi nhuận gộp cực đoan này dựa trên các kịch bản lý tưởng, khi đó nhà cung cấp có thể tạo ra khoảng 49 đô la mỗi giờ. DeepSeek công bố rằng doanh thu thực tế mỗi thẻ mỗi giờ trong thời gian không cao điểm khoảng 38 đô la, và môi trường sản xuất có thể đạt khoảng 80% hiệu suất của bài kiểm tra chuẩn. Dựa trên những con số mới nhất này, tỷ lệ lợi nhuận gộp thực tế nằm trong khoảng từ 84.2% đến 96.1%."
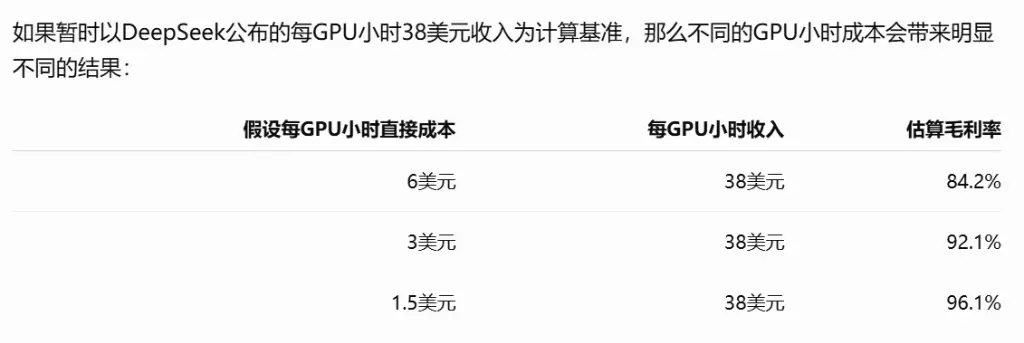
Hiện tại, trong thị trường dịch vụ đám mây nước ngoài, chi phí tổng hợp để thuê một GPU hàng đầu thường dao động từ 2 đến 4 đô la mỗi giờ. Sự chênh lệch lớn giữa giá trị sản xuất mỗi thẻ 38 đô la và chi phí tính toán đơn vị chính là cơ sở cốt lõi để đẩy cao ước tính tỷ lệ lợi nhuận gộp.
Phân tích ngang ngành: Lợi nhuận của các phòng thí nghiệm hàng đầu
Sau khi công bố tính toán này, nó đã nhanh chóng gây ra một cuộc thảo luận dây chuyền về khả năng sinh lời thực sự của các phòng thí nghiệm AI hàng đầu trong ngành.
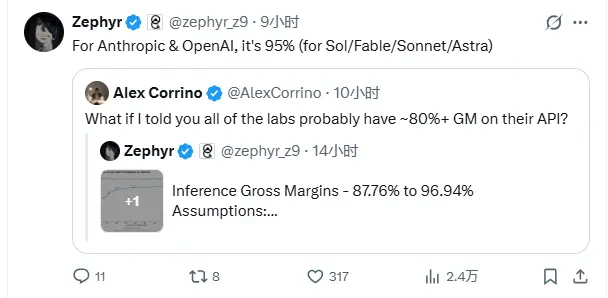
Nhà quan sát đầu tư công nghệ Alex Corrino đã đặt câu hỏi khi chia sẻ tính toán trên: "Nếu tôi nói với các bạn rằng tỷ lệ lợi nhuận gộp API của tất cả các phòng thí nghiệm AI hàng đầu thực sự có thể trên 80% thì sao?"
Zephyr ngay lập tức trích dẫn tweet đó và đưa ra một phán đoán mạnh mẽ hơn: "Đối với Anthropic và OpenAI, con số này thực sự là 95% (áp dụng cho các mô hình chủ lực như Sol, Fable, Sonnet, Astra)."
Anthropic chắc chắn đang kiếm được nhiều tiền?
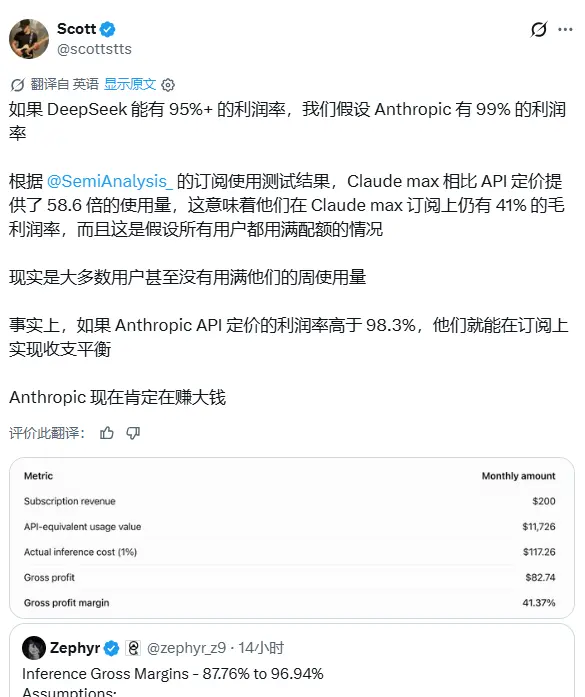
Dưới giả định rằng toàn ngành đều có lợi nhuận gộp cao, nhà phân tích đầu tư Scott đã chuyển đổi logic này sang mô hình kinh tế "đăng ký" của người dùng cuối, phân tích những lá bài thực sự của các công ty hàng đầu nước ngoài.
Theo báo cáo thực nghiệm của tổ chức nghiên cứu SemiAnalysis, giới hạn Token thực tế mà Anthropic cung cấp cho thành viên cao cấp "Claude Max" đã đạt tới 58.6 lần giá trị đơn giá API tương ứng của nó. Bên ngoài đã từng cho rằng, người dùng đăng ký với khối lượng cao sẽ tiêu tốn lợi nhuận của nền tảng dẫn đến lỗ.
Scott đã đưa ra công thức suy diễn ngược:
Thiết lập giả định cơ bản: giả định rằng tỷ lệ lợi nhuận gộp phần cứng API của Anthropic cũng đạt 99% (chi phí chỉ 1%).
Chi phí suy diễn ngược trong trường hợp sử dụng cực đoan: người dùng trả 1 đơn vị phí đăng ký, nếu tiêu thụ hoàn toàn tương đương với 58.6 đơn vị giá trị API, chi phí phần cứng thực tế mà Anthropic phải chịu là:
Chi phí phần cứng thực tế = 58.6×1% = 0.586 đơn vị
Suy diễn tỷ lệ lợi nhuận gộp trong trường hợp cực đoan:
Tỷ lệ lợi nhuận gộp cực đoan của Claude Max = 1−0.5861=41.4% Tỷ lệ lợi nhuận gộp cực đoan của Claude Max = 11−0.586=41.4%
Từ đó, Scott phân tích rằng:
"Nếu tỷ lệ lợi nhuận gộp của DeepSeek có thể đạt trên 95%, giả sử tỷ lệ lợi nhuận gộp API của Anthropic là 99%. Dựa trên thử nghiệm của SemiAnalysis, Claude Max cung cấp mức sử dụng lên tới 58.6 lần giá trị API. Điều này có nghĩa là, ngay cả khi tất cả người dùng đều sử dụng hết hạn mức, Anthropic vẫn có thể giữ lại khoảng 41% tỷ lệ lợi nhuận gộp trong mô hình đăng ký. Và thực tế, hầu hết người dùng sẽ không sử dụng hết hạn mức hàng tuần."
Ông chỉ ra rằng: "Thực tế, chỉ cần tỷ lệ lợi nhuận của API của Anthropic duy trì trên 98.3%, ngay cả khi người dùng sử dụng hết hạn mức, mô hình kinh doanh đăng ký của họ cũng có thể đạt được cân bằng tài chính. Anthropic hiện đang ở trạng thái sinh lời ổn định."
Tài khoản phân tích công nghệ Teortaxes cũng đánh giá rằng: "Trước kiến trúc tự phát triển của các phòng thí nghiệm chủ lực, tất cả các bài kiểm tra chuẩn công khai trên thị trường đều không đáng kể. Đây là kết quả của việc làm kỹ thuật nghiêm túc, và dịch vụ suy diễn bản thân là một cỗ máy in tiền. Bạn có thể tưởng tượng Dario (Giám đốc điều hành của Anthropic) hiện tại đang lo lắng như thế nào."
Sự khác biệt trong con đường công nghệ: Tái cấu trúc phần mềm vs Chip chuyên dụng
Khi cấu trúc chi phí suy diễn thực tế hiện ra, ngành công nghiệp cũng đã xem xét lại các con đường giảm chi phí công nghệ khác nhau.
Về kiến trúc phần cứng và chi phí thông lượng đơn vị, ngành đã so sánh giải pháp này với các nhà sản xuất chip như Groq, chuyên về độ trễ cực thấp.
Các nhà quan sát trong ngành chỉ ra rằng, kiến trúc phần cứng LPU tùy chỉnh đại diện cho Groq phụ thuộc vào SRAM gắn trên bo mạch, đổi lấy tốc độ tạo ra tương tác cực nhanh, nhưng dung lượng bộ nhớ chip của nó rất nhỏ, cần phải xếp chồng nhiều bo mạch phần cứng và kết nối các nút lớn để hỗ trợ các mô hình lớn chính thống, dẫn đến chi phí khấu hao phần cứng và ngưỡng mua sắm cho mỗi Token cao.
Ngược lại, DeepInfer đã trình bày một logic sổ sách khác cho con đường chip chung: chỉ bằng cách sử dụng phần mềm để điều phối tối ưu hóa, khai thác tối đa thông lượng đồng thời trên GPU chung và NPU thương mại như Ascend, để đổi lấy không gian lợi nhuận cho dịch vụ API quy mô lớn với chi phí phần cứng tổng hợp thấp hơn.
Tuy nhiên, nhiều nhà quan sát trong ngành đã chỉ ra rằng, ước tính lợi nhuận gộp từ 80% đến 95% chủ yếu tập trung vào chênh lệch trực tiếp giữa "giá Token và tiêu thụ phần cứng mỗi thẻ". Tính toán vi mô này không tính đến chi phí nghiên cứu và phát triển (R&D) hàng triệu đô la cho mô hình cơ bản ban đầu, chi phí mạng băng thông cao toàn cầu, cũng như mức lương cao của đội ngũ kỹ sư hệ thống.
Tiếp theo cần xác minh, là việc triển khai mã nguồn mở có thể ổn định tăng thông lượng và giảm chi phí cho mỗi Token đầu ra hiệu quả dưới các phần cứng khác nhau và tải công việc thực tế hay không. Đối với DeepSeek, bên ngoài cũng cần nhiều dữ liệu về chi phí và tỷ lệ sử dụng tài nguyên hơn, để có thể đánh giá xem lợi nhuận gộp cao được ước tính từ mạng xã hội có gần với mức hoạt động thực tế hay không.